2026.10.04広告・PRを含む記事です
【spark】マイクラサーバーが重い原因をコマンドで特定する方法
- TPSが低下してラグいけれど、どのプラグインが原因なのか絞り込めない
- 参加者が多くて、プラグインを1つずつ止めて再起動する調査ができない
- DockerやPterodactyl環境でも問題なく負荷診断ができるのか不安
サーバーがラグいとき、何となくプラグインを停止して再起動を繰り返しても解決には時間がかかります。
Paperサーバーなどに標準搭載されている診断ツールsparkを使えば、サーバーを稼働させたまま、どのプラグインやエンティティが処理時間を圧迫しているかをコマンド1つで特定できます。
この記事では、sparkを使った重い処理の計測手順から、突発的なラグスパイクの特定方法までわかりやすくまとめました。
読み終えるころには、勘に頼らず数値で原因を突き止められるようになり、無駄な再起動をせずにサーバーの軽さを取り戻せます。
サーバーが重いけれど、どのプラグインが原因なのか見当がつかないな。

sparkならサーバーを再起動せず、プレイヤーがログインした状態のまま本番の負荷を計測できるよ。
sparkとは?Paper同梱の負荷診断プラグイン
sparkは、マイクラサーバーの重い処理をコマンドだけで特定できる負荷診断プラグインです。
Paper 1.21以降のサーバーには標準で同梱されており、追加のインストール作業なしにコマンドを打つだけで使えます。
sparkには次の3つの機能があります。
| 機能名 | コマンド例 | 用途と特徴 |
|---|---|---|
profiler | /spark profiler start | サーバー内の処理を細かく計測し、どのプラグインやMODが重いかを数値で示します。 |
tickmonitor | /spark tickmonitor | 処理が重くなった瞬間のtickを自動で検知し、コンソールへ通知します。 |
health | /spark health | TPSやCPU、メモリなどサーバー全体の状態を1つのレポートにまとめます。 |
以前はTimingsという診断ツールが使われていましたが、現在は非推奨となりPaperでは既定で無効化されています。これから負荷を調査する場合はsparkを使用します。
Modrinthのspark配布ページ(/mod/spark)で配布されているのは、FabricやForge、NeoForge、Quilt向けのMOD版です。
Paperサーバーではsparkが同梱されているため、このMOD版を別途探す必要はありません。
Spigot系サーバーでプラグイン版を導入する場合は、HangarなどPaper・Spigot向けの配布経路からダウンロードします。
TPSだけでは重い原因までわからない理由
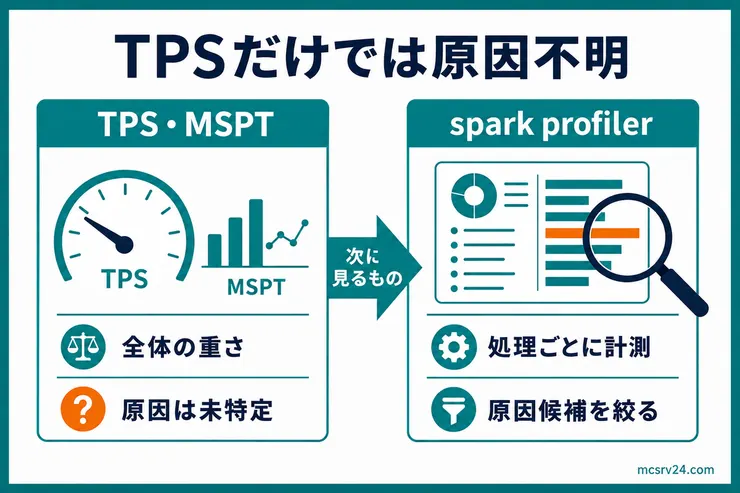
サーバーの遅延を把握する際、TPSの確認だけでは不十分です。
マイクラの世界は、1秒間に20コマ進むパラパラ漫画のような仕組み(tick)で動いています。1秒間に20コマ進んだ状態がTPS 20で、正常なサーバーの基準です。
1コマの処理にかかった時間がMSPTです。1秒(1000ミリ秒)を20コマで割ると、1コマあたり50ミリ秒以内に処理が終わればTPS 20を保てます。
大量のMobや重いプラグインによって1コマに80ミリ秒以上かかると、TPSが低下してラグが発生します。
| 指標 | 何がわかるか | 正常値の目安 |
|---|---|---|
| TPS | 1秒あたりに処理できたtickの回数の平均 | 20 |
| MSPT | 1回のtickの処理にかかった時間 | 50ms以下 |
TPSやMSPTは「全体として遅延が発生しているか」を測るメーターです。実際にどのメソッドやタスクが時間を食っているのかを割り出すには、処理内訳を細かくサンプリングするsparkのprofilerが必要です。
計測を開始して結果を読むまでの基本の流れ
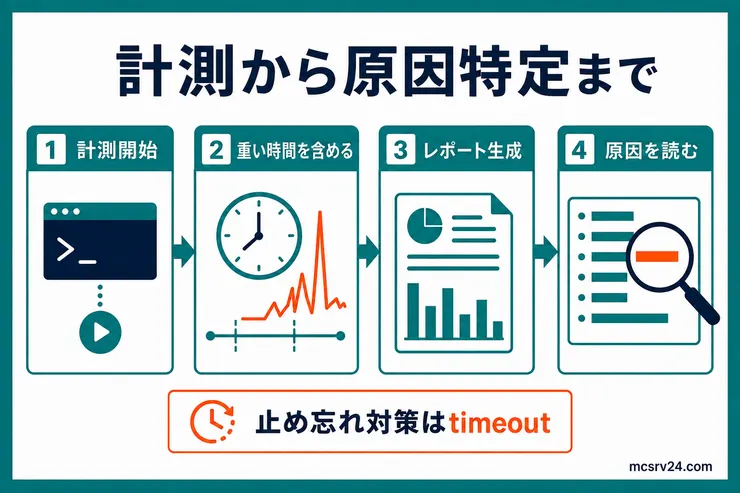
sparkのprofilerは、次の流れで使います。
/spark profiler startで計測を開始する- 重くなるタイミングを含めて数分から十分程度待つ
/spark profiler stopで計測を終了する- 生成されたレポートのURLを開く
使うコマンドは多くありません。
| コマンド | 内容 |
|---|---|
/spark profiler start | 計測を開始する |
/spark profiler stop | 計測を終了してレポートを生成する |
/spark profiler cancel | 計測を中断してレポートを作らずに破棄する |
/spark profiler info | 現在計測中かどうかを確認する |
/spark profiler open | 計測を停止せずに稼働中のプロファイラー結果を表示する |
--timeout <秒> | 指定した秒数が経過すると自動で計測を停止する |
--thread * | 全スレッドを対象に計測する |
--alloc | CPU使用率の代わりにメモリ割り当てを計測する |
計測を自動で止めたい場合は、開始時に--timeoutオプションを付けます。指定した秒数が経過すると自動で計測が終了し、レポートが生成されます。
/spark profiler start --timeout 600たとえば--timeout 600と指定すると、10分後に自動停止するため止め忘れの心配がありません。
一瞬のラグスパイクだけを捕まえる方法
一瞬だけ発生するラグスパイクは、通常の計測時間では捕まえにくい問題です。
sparkでは、次の2つの方法でラグスパイクだけを狙って記録できます。
- 重いtickが起きた瞬間だけ通知する
- 一定時間以上かかった処理だけを記録する
この2つは似た用途に見えますが、使うコマンドもオプションも別物です。
tickmonitorの--threshold-tickを使うと、重いtickをリアルタイムで検知して通知します。
profiler startの--only-ticks-overは、重いtickだけを狙って処理の中身を記録するためのオプションです。
コマンド自体が違うため、片方に付けたつもりのオプションがもう片方に反映されることはありません。
重いtickが起きた瞬間だけ通知する
/spark tickmonitorは、他のサブコマンドを付けずに単独で実行します。
実行するたびに有効と無効が切り替わる、トグル式のコマンドです。
/spark tickmonitorしきい値の指定にはオプションを使います。
| オプション | 引数 | 動作内容 |
|---|---|---|
--threshold | <percent> | 平均より指定した割合以上遅いtickを検知します。 |
--threshold-tick | <ms> | 指定した処理時間(ミリ秒)を超えたtickを検知します。 |
--without-gc | なし | ガベージコレクション(GC)が起きたことの通知を出さなくします。GCで長くなったtickは、引き続き検知されます。 |
通知はコマンドを実行した人や、通知を受け取る権限を持つ管理者に届きます。処理の内訳までは記録されません。
異常が発生した瞬間の処理内容まで詳しく調べたい場合は、後述するprofilerの--only-ticks-overと組み合わせて活用します。
一定時間以上かかった処理だけを記録する
スパイク発生時の詳細ログを残したいときは、--only-ticks-overオプションを付けてprofilerを開始します。
/spark profiler start --only-ticks-over 100指定した処理時間(ミリ秒)を超えた重いtickのみが抽出して記録されます。通常のtick基準である50msを上回る、50〜100ms程度を指定するのが目安です。
サーバー全体の健康状態をレポートで確認する
サーバー全体の状態は、目的に合わせて3つのコマンドで見られます。
| コマンド | 結果の出方 |
|---|---|
/spark health | Web上のライブダッシュボードが開き、10秒ごとに自動で更新される |
/spark health show | 簡単なレポートがその場に文字で表示される |
/spark health upload | 更新されない静的なレポートをWebにアップロードする |
/spark healthレポートには多くの項目が並びますが、初心者が読み取るのはTPS、CPU使用率、メモリ使用率の3点で十分です。
これ以外の項目は、原因を特定したあとに詳しく調べれば足ります。
チームやDiscordで結果を共有したい場合は、静的なレポートをWeb上にアップロードする/spark health uploadが便利です。
/spark health upload発行されたURLのリンクを送るだけで、他の人にも同じ画面を共有できます。
JVMのメモリ使用状況をさらに詳しく調べたい場合は、/spark health show --memoryを指定してください。
/spark health show --memoryDockerやPterodactylでsparkを使うときに知っておくこと
Docker環境やPterodactylパネルでは、sparkの一部機能が制限を受けます。
主な症状は次の2つです。
| 症状 | 原因 | 対処 |
|---|---|---|
| profiler起動時にlibstdc++関連のエラーが出る | ネイティブライブラリの不足 | Alpineベースのイメージならapk add libstdc++、Debian・Ubuntuベースならapt install libstdc++6を実行する |
| perf-eventsが使えないという表示が出る | perf-eventsを使うための権限(SYS_ADMIN)が付与されていない | Docker起動時に--cap-add SYS_ADMINを付ける必要があるが、多くのPterodactyl利用者はホスト側の権限のため自分では設定できない |
この対処ができない環境でも、sparkが使えなくなるわけではありません。
perf-eventsの権限が足りない環境では、sparkが使うasync-profilerが自動的に「itimer」という別の方式に切り替わり、計測を続けます。
profiler・tickmonitor・healthはそのまま動作します。perf-eventsが要るのは、Java以外のネイティブコードの中まで細かく見たいときです。
Pterodactylでホスト側の権限を自分で変更できない場合は、無理に設定を探さず、このまま使って問題ありません。
診断結果から次にやることを決める
profilerの結果を読んだあとにやることは、原因が絞れたかどうかで変わります。
次のどれに当てはまるかが、進む方向の分かれ目です。
- ワールド生成が重いとわかった場合
- メモリやCPUの使用率が上限に張り付いている場合
- sparkだけでは原因が絞れない場合
いずれの場合も、profilerの結果に出てきた処理名を手がかりに次の一手を選びます。
ワールド生成が重いとわかった場合
profilerの結果で、チャンク生成やワールド関連の処理が上位に並んでいる場合、原因は地形生成です。地形生成プラグインを入れているなら、その処理が含まれていることもあります。
どちらの場合も、探索前にワールドを生成しておく対策が有効です。
Chunkyでワールドを事前生成する方法を使うと、プレイヤーが探索する前にチャンク生成を済ませておけます。
メモリやCPUの使用率が上限に張り付いている場合
/spark healthのメモリ使用率が常に高止まりしている場合、容量が足りていない可能性があります。ただし、GCが動く前は使用率が高く見えるのがふつうです。GC後も使用量が下がらないか、GCが頻繁に起きていないかを確かめ、特定のプラグインがメモリを使い続けていないかは/spark profiler start --allocで調べます。
先にメモリ割り当ての目安を見て、搭載メモリに対する割り当てが妥当かどうかを確かめてください。
割り当てを増やす余地がないときは、人数別のスペック目安と実際の参加人数を見比べてみてください。
レンタルサーバーを利用しているなら、管理画面からプランを変更してメモリを増やせます。自宅PCのメモリが限界に達している場合は、ConoHa for GAMEのようなメモリ容量を柔軟に選べる環境への移行も検討してみてください。
sparkだけでは原因が絞れない場合
profilerの結果を見ても、特定のプラグインや処理に負荷が集中しておらず、原因を1つに絞れないことも珍しくありません。
負荷が分散していても、プラグインが無関係とは限りません。プラグイン以外の要因もあわせて疑います。
原因をプラグインに限定せず、マイクラサーバーが重い原因を一通りチェックする記事で、メモリやMob、回線まで含めて洗い出せます。
よくある質問
Q診断結果を公開URLにせず、サーバー内へ保存できますか?
`/spark profiler stop --save-to-file`を使うと、結果をsparkの設定フォルダ内へファイルとして保存できます。プレイヤー名などを外部へ共有したくない場合は、公開URLを発行せず管理者だけで確認します。
Q一般プレイヤーもspark profilerを実行できますか?
通常は実行できません。sparkやspark.profilerなどの権限が必要です。負荷測定の結果には運営情報が含まれるため、コンソールか信頼できる管理者だけで実行します。
まとめ:sparkでラグの原因を数値で特定する
sparkのprofilerで処理ごとの負荷を数値で見れば、設定を闇雲に変えずに原因のプラグインを絞り込めます。一瞬だけ固まるラグは、tickmonitorと--only-ticks-overで捕まえられます。
- ワールド生成が原因:Chunkyで事前生成する
- メモリやCPUが上限に張り付いている:割り当てとスペックを見直す
- 特定のプラグインが原因:入れ替えるか、そのプラグインの設定を見直す
計測しても負荷が見当たらないなら、原因はサーバーの処理の外でしょう。サーバーが重い・落ちるときの診断で、回線や参加者側の環境まで範囲を広げて確かめられます。
メモリが上限に張り付いていて自宅PCでは増やせないなら、プランでメモリを選べるレンタルサーバーへ移すと、計測で足りないとわかった分をそのまま足せます。